Daikoku · avril 2026
Framework avec un pipeline end to end qui ne ment pas en backtests
Un framework open source de prédiction directionnelle sur les cryptomonnaies, basé sur l'architecture Mamba, de l'ingestion des données à l'inférence en direct.
Un modèle de prévision qui paraît excellent sur le passé, puis échoue en réel à cause de fuites de données.
Une chaîne complète qui empêche les fuites par construction et mesure l'avantage réel du modèle, jusqu'au direct.
J’ai construit Daikoku pour répondre à un problème d’ingénierie précis : une chaîne de machine learning de niveau production pour les séries temporelles financières, qui ne mente pas lors des tests sur le passé.
C’est un framework open source (licence MIT) de prédiction directionnelle sur les cryptomonnaies, basé sur l’architecture Mamba. Environ 30 000 lignes de Python, plus de 350 tests, et un cycle complet de l’ingestion des données brutes jusqu’à l’inférence en direct, piloté par un seul fichier de configuration.
Illustration sur des prix simulés : à chaque bougie, le modèle estime la probabilité d'une baisse, d'une hausse ou d'un marché incertain, et ne prend position que si l'une dépasse son seuil de confiance de 55 %.
Un étiquetage sans fuite de données
La classification repose sur la méthode Triple Barrier, adaptée avec des niveaux dynamiques calés sur la volatilité. Pour chaque bougie, le modèle évalue si le prix touchera un objectif de gain, un stop, ou expirera sans toucher aucune barrière. Sept modes de prédiction partagent la même chaîne.
Les barrières sont calculées sur les données brutes, avant toute transformation : sinon, les relations de prix sont altérées. Six tests unitaires dédiés vérifient l’intégrité de la chaîne. Le plus critique modifie les données futures et vérifie que les variables passées restent identiques au bit près.
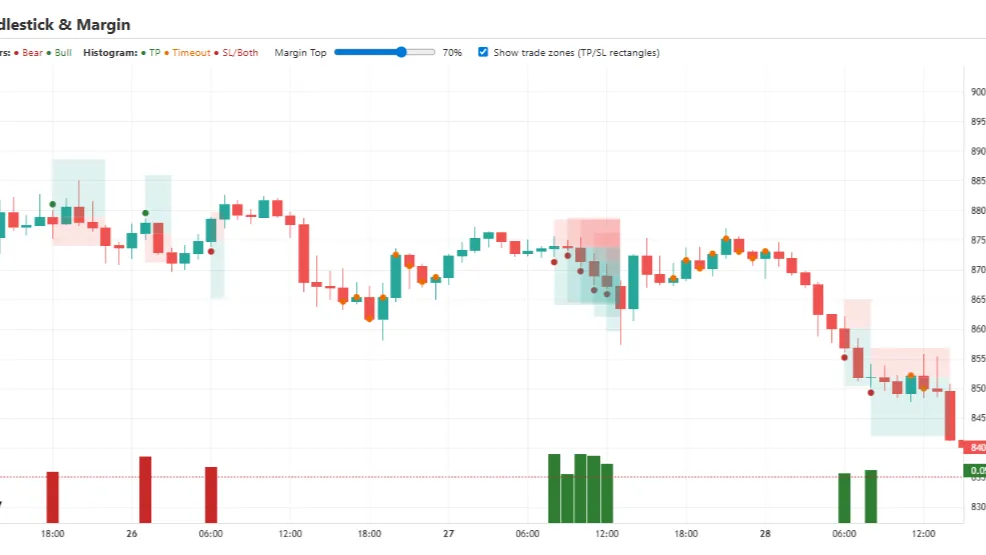
L’étiquetage Triple Barrier : pour chaque bougie, la zone d’objectif, la zone de stop et l’issue (objectif, stop ou expiration).
L’architecture Mamba
Là où un Transformer calcule une attention globale dont le coût croît avec le carré de la longueur, Mamba traite les séquences en temps linéaire. Résultat : des fenêtres de plus de 200 bougies sur deux échelles de temps simultanées, avec une optimisation multi-objectifs sur une carte graphique grand public.
Quatre modes de fusion relient les deux échelles de temps. Le plus avancé injecte le contexte de l’échelle longue dans l’échelle courte, position par position, via une connexion résiduelle à porte qui apprend combien de contexte injecter. Sans carte graphique, un mode de repli en PyTorch pur garantit l’inférence et l’évaluation.
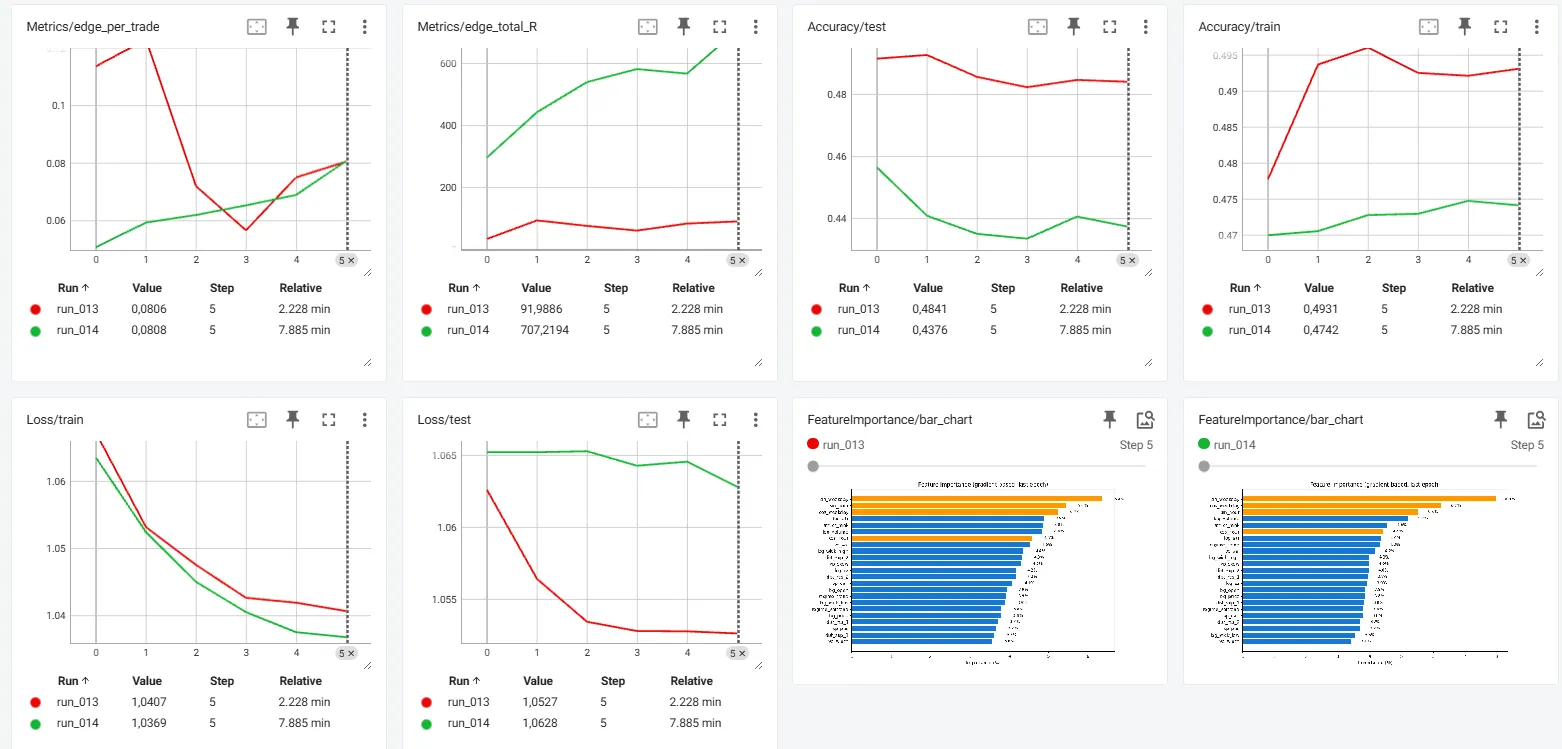
Une session d’entraînement suivie dans TensorBoard : pertes, justesse, avantage par trade et importance des variables.
23 variables par fenêtre
Les variables se répartissent en trois familles : 12 variables globales (prix, volatilité, encodage cyclique de l’heure et du jour, filtre de régime), 6 variables structurelles (supports, résistances, zigzag) et 5 variables de profil de volume. Les distances sont exprimées en unités de volatilité pour rester comparables d’un régime de marché à l’autre.
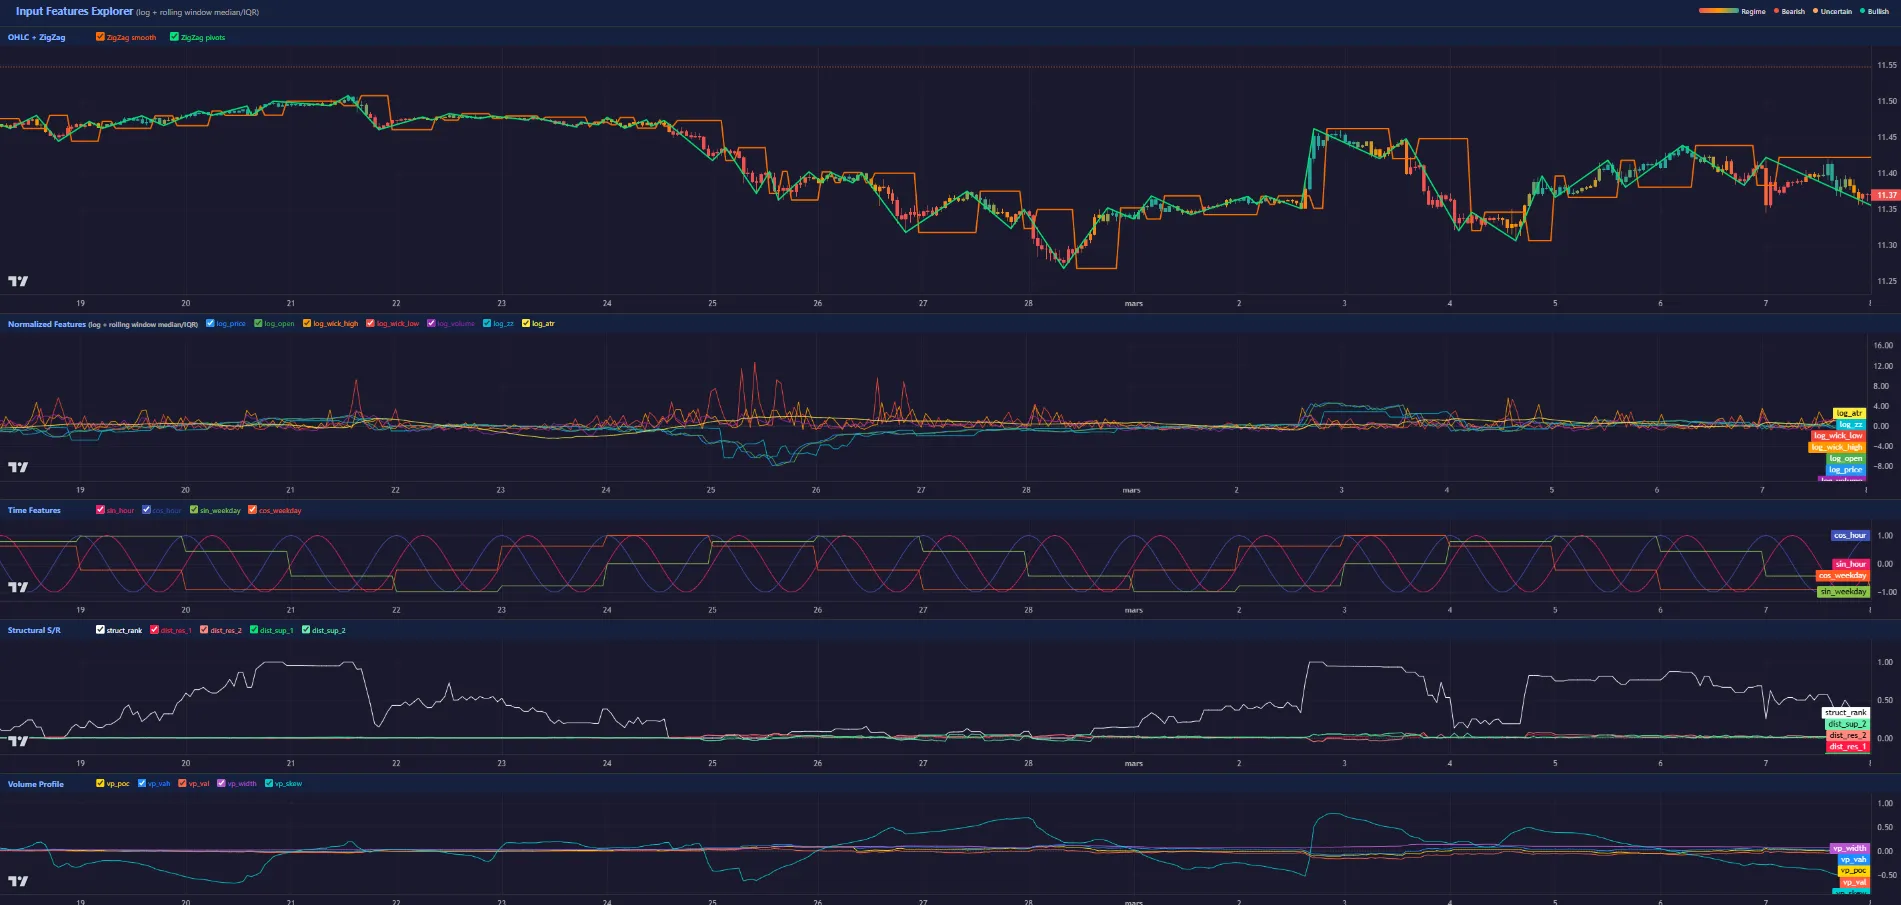
L’explorateur des 23 variables calculées sur chaque fenêtre.
De l’entraînement au direct
Quatre modes partagent la même chaîne de données :
- Entraînement, avec sauvegarde des meilleurs modèles et précision mixte.
- Optimisation multi-objectifs sur trois axes : avantage total, écart entre entraînement et test, avantage par position.
- Évaluation dans un rapport interactif, avec simulation de performance.
- Inférence en direct, connectée aux plateformes d’échange, avec tableau de bord. Le moteur réutilise exactement le code d’assemblage des variables de l’entraînement, et un mode de comparaison vérifie régulièrement la parité.
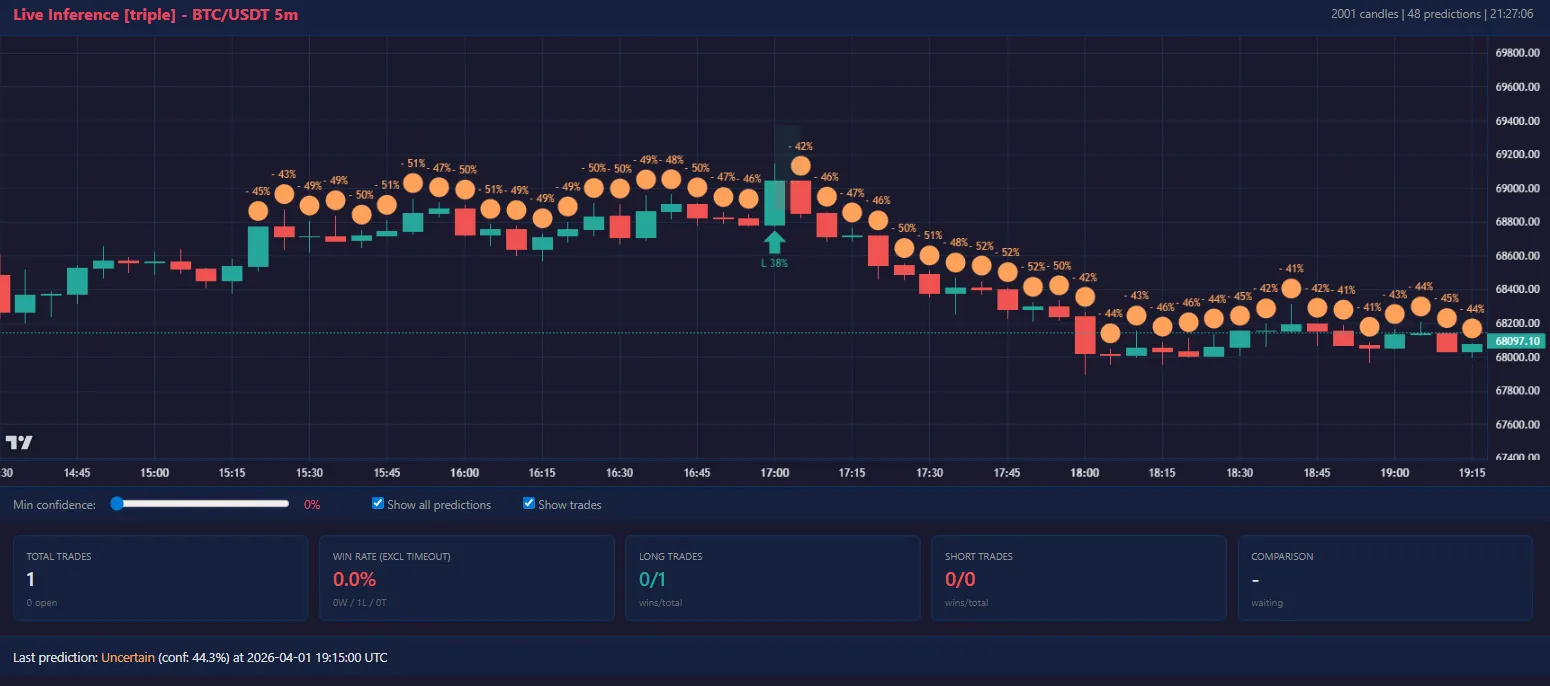
Le tableau de bord d’inférence en direct, sur BTC/USDT en bougies de 5 minutes.
Ce que j’en retiens
Un modèle de prévision ne vaut que par l’honnêteté de son évaluation. Toute l’architecture est conçue pour qu’un bon score sur le passé soit un vrai bon score.