Assistant documentaire · octobre 2025
Un assistant documentaire livré sur les serveurs d'un client
Pour une PME industrielle, un assistant qui retrouve la bonne pièce dans des milliers de PDF, installé sur ses propres serveurs et relié à son Active Directory. Il repose sur Mimir, ma plateforme RAG publiée sur GitHub.
Le support cherche la bonne pièce dans des milliers de documents, et la qualité de la réponse dépend de qui décroche.
Le support identifie la bonne pièce plus vite, la page source sous les yeux, et la réponse ne dépend plus de qui décroche.
---
title: "Assistant documentaire : de la question du support à la réponse sourcée"
---
flowchart TB
  n_screen["Assistant documentaire · Connecté par l'Active Directory"]
  subgraph n_serveurs["Sur vos serveurs"]
    n_orch["Orchestrateur · API sécurisée, droits de l'Active Directory"]
    n_rag["Moteur RAG · Recherche par mots-clés et par sens"]
    n_vec["Index vectoriel · FAISS, embeddings calculés sur site"]
    n_pipe["Traitements asynchrones · Nomenclatures reliées en graphe"]
    n_db["Base de données · Documents, références, journal d'audit"]
  end
  n_llm["Modèle de langage · Mistral AI, en Europe : ne reçoit que les extraits"]
  n_screen -- "question du support" --> n_orch
  n_orch <-- "question, puis passages et pièce" --> n_rag
  n_rag <-- "recherche par sens, passages proches" --> n_vec
  n_rag <-- "références citées, pièce trouvée" --> n_pipe
  n_pipe <-- "machine et pièce, référence et page" --> n_db
  n_orch -- "extraits utiles seulement" --> n_llm
  n_llm -- "réponse sourcée" --> n_screen
Le contexte
Une PME qui fabrique des machines et des pièces semi-industrielles. Ses techniciens indépendants, en intervention chez les clients finaux, appellent le support pour identifier la bonne pièce. L’information existe, mais elle est dispersée dans des milliers de PDF : notices, vues éclatées, nomenclatures, auxquels s’ajoutent des procédures de fabrication et des guides mal classés. Le support passe une partie de ses appels à chercher, et la qualité de la réponse dépend de qui décroche.
Les contraintes
- Les documents restent chez le client : il refusait qu’un service en ligne stocke son corpus, mais acceptait que des extraits partent ponctuellement vers un modèle de langage européen.
- Un système d’information ancien : l’outil devait s’intégrer à l’existant, un Active Directory sous Windows Server 2008 R2.
La solution : Mimir, adapté en un mois
Je suis parti de Mimir, ma plateforme RAG publiée sur GitHub. Je l’avais construite de zéro, chaque composant pensé pour la performance, la sécurité et la maintenance : environ 28 000 lignes de code, entre un back-end FastAPI et une interface React, une recherche hybride par mots-clés et par sens. Elle gère plus de 50 000 documents et 2 000 requêtes par heure sur une machine standard.
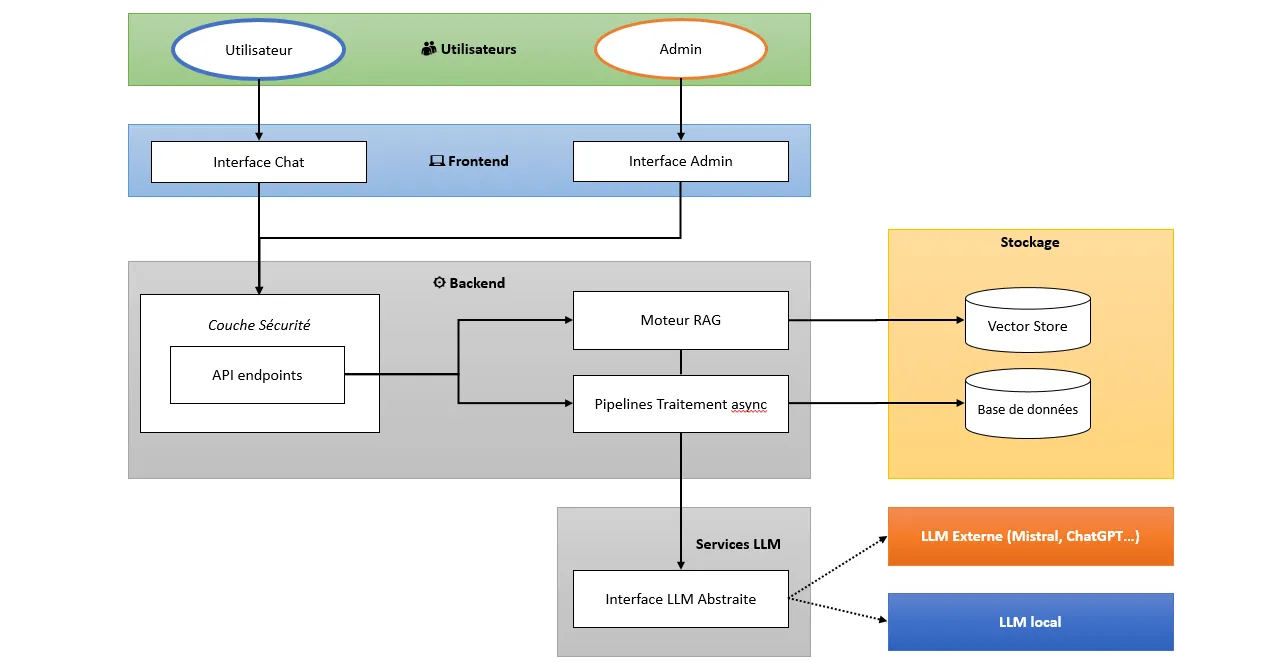
L’architecture de Mimir : interfaces utilisateur et administration, couche de sécurité, moteur RAG, traitements asynchrones, stockage et modèles de langage interchangeables.
- Sur les serveurs du client : une machine virtuelle Linux dédiée sur son hyperviseur, avec 4 vCPU (8 pendant l’indexation initiale), 16 Go de RAM et 100 Go de disque. Documents, embeddings (calculés sur site avec bge-m3) et index FAISS restent dans ses murs. Seuls les extraits utiles à chaque question partent vers l’API de Mistral AI ; une couche d’abstraction permet de passer à un autre modèle, jusqu’à un modèle local, sans verrouillage.
- Retrouver la bonne pièce : les références sont extraites des tableaux de nomenclature, puis reliées entre elles (machine, sous-ensemble, pièce) dans un graphe (GraphRAG). Le support retrouve ainsi une référence à partir d’une simple description.
- Des réponses vérifiables : chaque réponse cite sa page source, et l’assistant refuse de répondre quand l’information n’est pas dans les documents. Les réponses ont été validées sur des questions réelles posées au support.
- L’accès : réservé au réseau de l’entreprise, avec authentification par l’Active Directory. L’outil a ensuite été ouvert à toute l’entreprise pour la documentation interne ; j’ai proposé des droits par groupe Active Directory, le client a préféré un accès commun.
- L’exploitation, héritée du socle : l’ingestion des documents tourne en arrière-plan, un journal d’audit trace connexions et changements, et le tableau de bord d’administration suit l’usage, les journaux et le plafond de coûts IA.
Les difficultés
L’authentification sur un Active Directory 2008 R2, hors support depuis 2020, a pris plus de temps que prévu. J’ai recommandé au client de planifier sa migration.
Ce que ça a changé
Le support identifie la bonne pièce plus vite et répond avec la page source sous les yeux ; le gain le plus net est la qualité et la régularité des réponses. L’adoption s’est faite sans résistance : chaque réponse se vérifie d’un coup d’œil, et l’équipe a été formée à la livraison.
Mon rôle
Cadrage, adaptation de Mimir (embeddings sur site, graphe des nomenclatures, intégration à l’Active Directory), fiabilisation des réponses, déploiement et formation.
Ce que j’en retiens
Construire de zéro a été un accélérateur de maîtrise : je sais ce qui sépare un prototype d’une solution de production. C’est ce qui me permet aujourd’hui de choisir la bonne architecture pour chaque besoin, sur mesure ou en tirant le meilleur des outils du marché.